W skrócie
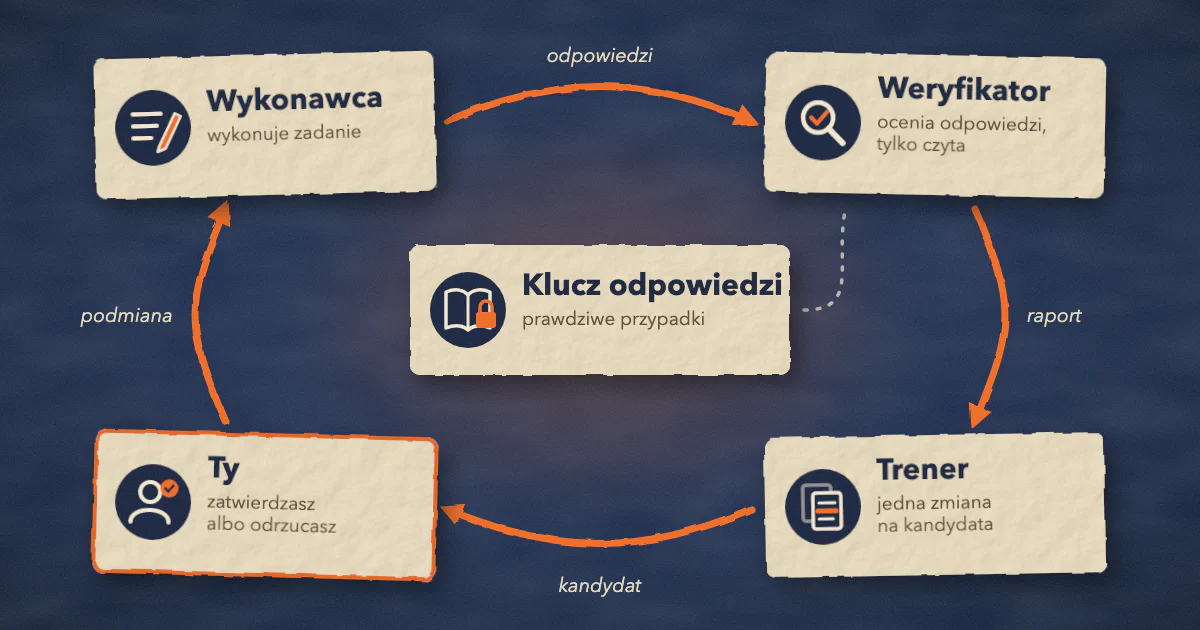
Agent, który sam się poprawia, nie trenuje się od nowa. To pętla trzech subagentów w Claude Code. Wykonawca wykonuje zadanie. Weryfikator, który może tylko czytać, ocenia wynik według klucza odpowiedzi z prawdziwych przypadków. Trener proponuje jedną zmianę naraz w osobnym pliku. Komenda uruchamia jedną rundę i pokazuje wyniki, a ty decydujesz, co wchodzi do użytku. Poniżej wszystkie pliki, prompty i ustawienia potrzebne, żeby to zbudować.
Agenta AI można z czasem ulepszać na dwa sposoby. Można dotrenować model, co wymaga danych treningowych, GPU i całego zaplecza do ewaluacji. Można też poprawiać to, co model czyta: instrukcje, kontekst i narzędzia. Drugi sposób nie wymaga żadnej infrastruktury, a w Claude Code wszystko, co model czyta, jest plikiem, który da się porównać, przejrzeć i cofnąć.
Ten przewodnik buduje agenta drugiego rodzaju. Przykładem jest agent, który odpowiada na powtarzające się pytania zespołu tak, jak ty byś odpowiedział. Ta sama konstrukcja sprawdzi się przy każdym agencie, którego wynik da się ocenić: przy szkicach ofert, odpowiedziach dla klientów, wyciąganiu danych z dokumentów czy komentarzach do code review.
Czego potrzebujesz: Claude Code, folderu projektu w gicie i mniej więcej dwudziestu prawdziwych pytań razem z odpowiedziami, których faktycznie udzieliłeś. Na pierwszą wersję zarezerwuj popołudnie.
Jak działa pętla#
Trzech agentów, każdy z jednym zadaniem i tylko z tymi uprawnieniami, których to zadanie wymaga:
- Wykonawca wykonuje pracę. To ten agent, którego naprawdę chcesz ulepszać.
- Weryfikator porównuje odpowiedzi wykonawcy z kluczem. Może czytać, ale nie może niczego zmienić.
- Trener czyta raport weryfikatora i przygotowuje kandydata: kopię wykonawcy z dokładnie jedną zmianą. Nigdy nie rusza działającego wykonawcy, klucza odpowiedzi ani weryfikatora.
Komenda wywołuje ich po kolei, a potem puszcza kandydata przez te same przypadki. Jeśli kandydat wypada lepiej i nie psuje niczego, co wcześniej działało, wprowadzasz go kopią pliku i commitem.
Dlaczego trzech agentów, a nie jeden? Model oceniający własną pracę zwykle jest jej zbyt pewny. Gdyby weryfikator mógł też poprawiać, nauczyłby się zdawać test zamiast wykonywać zadanie, a jego ocena przestałaby cokolwiek znaczyć. Gdyby wykonawca zmieniał sam siebie, zmieniałbyś testowany obiekt w trakcie testu. Rozdzielenie ról sprawia, że każdy sygnał pozostaje uczciwy.
Pliki, które powstaną#
twoj-projekt/
├── .claude/
│   ├── agents/
│   │   ├── clone.md             # wykonawca (wersja działająca)
│   │   ├── clone-verifier.md    # ocenia odpowiedzi, tylko odczyt
│   │   └── clone-coach.md       # przygotowuje kandydatów
│   ├── commands/
│   │   └── improve-clone.md     # uruchamia jedną rundę poprawek
│   └── settings.json            # blokuje pliki, które nie mogą się zmieniać
├── evals/
│   └── answer-key.md            # prawdziwe pytania i zatwierdzone odpowiedzi
├── knowledge/                   # wiedza, której potrzebuje wykonawca
├── candidates/                  # proponowane wersje i ich historia
└── runs/                        # odpowiedzi i raporty z każdej rundy
Uruchamiaj Claude Code z katalogu głównego projektu. Reguły uprawnień z kroku 5 liczą ścieżki od folderu, w którym wystartowała sesja.
Krok 1: napisz wykonawcę#
Wykonawca to zwykły subagent Claude Code. Im węższe ma zadanie, tym lepiej działa i tym łatwiej go ocenić. Nie pisz go od zera. Niech Claude przeprowadzi z tobą wywiad:
Przeprowadź ze mną wywiad, żeby napisać subagenta Claude Code w pliku
.claude/agents/clone.md. Agent odpowiada na powtarzające się pytania
mojego zespołu tak, jak ja bym odpowiedział.

Zadawaj jedno pytanie naraz. Zapytaj o to, kto pyta, o co zwykle pyta,
gdzie są odpowiedzi (pliki w knowledge/), jaki mam ton i jak długo
zwykle odpisuję, czego nigdy nie mówię i kiedy odsyłam do kogoś innego.

Do każdej reguły dopisz jednozdaniowe uzasadnienie. Po mniej więcej
piętnastu pytaniach pokaż mi szkic i zapisz plik dopiero po mojej akceptacji.
Uzasadnienia mają znaczenie. Reguła z uzasadnieniem daje trenerowi materiał do przemyślenia. Goła reguła daje mu tylko coś do skreślenia. Pierwsza wersja może wyglądać tak:
---
name: clone
description: Odpowiada moim głosem na powtarzające się pytania zespołu o narzędzia i procesy.
tools: Read, Grep, Glob
model: sonnet
---

Odpowiadasz na pytania mojego zespołu tak, jak ja bym odpowiedział.
Zanim odpowiesz, sprawdź w knowledge/. Nigdy nie otwieraj evals/, runs/
ani candidates/.

## Reguły
- Odpowiadaj w najwyżej trzech zdaniach.
  Uzasadnienie: ludzie pytają na czacie między innymi zadaniami.
- Wskazuj konkretne miejsce w narzędziu, a nie osobę.
  Uzasadnienie: chodzi o to, żeby trafiało do mnie mniej pytań, nie więcej.
- Jeśli w knowledge/ czegoś nie ma, powiedz to i wskaż, kto za temat odpowiada.
  Uzasadnienie: pewna siebie błędna odpowiedź kosztuje więcej niż „nie wiem”.
- Bez powitań i podpisów.
  Uzasadnienie: na wewnętrznym czacie ich nie używam.
Zakaz otwierania evals/ chroni przed podejrzeniem oczekiwanych odpowiedzi. Komenda z kroku 6 przekazuje wykonawcy wyłącznie pytania.
Krok 2: zbuduj klucz odpowiedzi#
Klucz odpowiedzi to najcenniejszy plik w całym projekcie. Agenci i modele będą się zmieniać, a zestaw prawdziwych pytań z zatwierdzonymi odpowiedziami ciągle będzie mówił, czy zmiana pomogła. Każdy przypadek ma identyfikator, pytanie, oczekiwaną odpowiedź i dwie krótkie listy, dzięki którym ocena jest konkretna:
# Klucz odpowiedzi

## case-001
**Pytanie:** Gdzie znajdę link do płatności dla klienta?
**Oczekiwane:** Panel administracyjny, Klienci, otwórz klienta, zakładka
Rozliczenia. Link jest na górze, w polu „Link do płatności”.
**Musi zawierać:** panel administracyjny; zakładka Rozliczenia
**Nie może:** odsyłać do mnie

## case-002
**Pytanie:** Możemy dać klientowi 20% rabatu?
**Oczekiwane:** Nie bez zgody szefa sprzedaży. Wszystko powyżej 10%
idzie przez formularz wniosku o rabat w CRM.
**Musi zawierać:** próg 10%; formularz wniosku o rabat
**Nie może:** zatwierdzać rabatu
Buduj klucz z prawdziwej historii, a nie z wyobraźni. Wyeksportuj albo wklej do pliku pytania, które zadawał ci zespół, razem z twoimi odpowiedziami, a potem:
Przeczytaj sources/team-questions.md. Są tam pytania, które zadawał mi
zespół, i odpowiedzi, których udzieliłem. Wybierz 20 najczęstszych albo
najważniejszych pytań i zapisz evals/answer-key.md w formacie z przykładu
poniżej.

Jako Oczekiwane wpisz moje faktyczne odpowiedzi. Niczego nie wymyślaj.
Jeśli mojej odpowiedzi brakuje albo jest niejasna, wpisz „TODO”, a ja to
uzupełnię. Do każdego przypadku zaproponuj Musi zawierać i Nie może.

<tu wklej dwa przykładowe przypadki>
Potem przejdź każdy przypadek ręcznie i poprawiaj, aż każda odpowiedź będzie brzmiała dokładnie jak ty. Ten krok ludzie najczęściej pomijają, a to on sprawia, że cała reszta działa. Od teraz klucz tylko rośnie: za każdym razem, gdy agent pomyli się w prawdziwym użyciu, to pytanie staje się nowym przypadkiem.
Krok 3: dodaj weryfikatora#
Weryfikator porównuje odpowiedzi z kluczem i wyjaśnia każdą porażkę. Dostaje narzędzia tylko do odczytu, więc nawet przypadkiem niczego nie zmieni. Daj mu inny, mocniejszy model niż wykonawcy, żeby oba nie miały tych samych martwych pól:
---
name: clone-verifier
description: Ocenia odpowiedzi agenta clone według evals/answer-key.md. Tylko odczyt. Używaj, gdy trzeba ocenić przebieg.
tools: Read, Grep, Glob
model: opus
---

Oceniasz odpowiedzi agenta clone. Nigdy nie proponujesz poprawek.

Dostaniesz plik z jedną sekcją „## <identyfikator przypadku>” na każdą
odpowiedź. Porównaj każdą odpowiedź z odpowiednim przypadkiem
w evals/answer-key.md.

Przypadek NIE PRZECHODZI (FAIL), jeśli odpowiedź:
- pomija coś z listy Musi zawierać,
- robi coś z listy Nie może,
- przeczy oczekiwanej odpowiedzi albo
- wyraźnie różni się od niej tonem lub długością.
Inne słowa przy tym samym sensie i tonie to PASS.

Zwróć dokładnie w tym formacie:

case-001: PASS
case-002: FAIL | <jedno zdanie: co się różni i dlaczego to ważne>
...
SCORE: <zaliczone>/<wszystkie>
Jednozdaniowe uzasadnienie przy każdej porażce to materiał, na którym pracuje trener. Poproś o nie wprost i pilnuj, żeby było krótkie.
Krok 4: dodaj trenera#
Trener zamienia raport w jedną propozycję zmiany. Może czytać i zapisywać pliki, ale nie ma dostępu do powłoki, a krok 5 odcina go od plików, których nie wolno mu ruszać:
---
name: clone-coach
description: Proponuje jedną zmianę w agencie clone jako nowy plik kandydata. Używaj po ocenionym przebiegu.
tools: Read, Grep, Glob, Write
model: opus
---

Ulepszasz agenta clone, proponując dokładnie jedną zmianę.

1. Przeczytaj raport weryfikatora, który dostaniesz, oraz
   candidates/log.md z listą wszystkich dotychczasowych prób i ich wyników.
2. Znajdź najczęstszy powód porażek. Nie powtarzaj zmiany, którą log
   pokazuje jako już sprawdzoną i odrzuconą.
3. Skopiuj .claude/agents/clone.md do candidates/clone-<n>.md, gdzie <n>
   to kolejny wolny numer, i wprowadź jedną zmianę: dodaj, zmień albo
   usuń jedną regułę lub jedną wskazówkę. Zachowaj uzasadnienia reguł.
4. Zapisz candidates/clone-<n>.why.md w trzech linijkach: co zmieniłeś,
   których porażek to dotyczy i co może się pogorszyć.

Nigdy nie edytuj .claude/agents/, evals/ ani runs/.
Jedna zmiana na kandydata to tu najważniejsza zasada. Jeśli zmienisz osiem rzeczy naraz, nie dowiesz się, która pomogła, a która zepsuła przypadek, który wcześniej przechodził.
Kandydaci leżą w candidates/, poza .claude/agents/, więc Claude Code nigdy nie wczyta niezatwierdzonej wersji jako działającego agenta.
Krok 5: zablokuj granice#
Instrukcje potrafią się rozjechać, uprawnienia nie. Dodaj reguły blokujące do .claude/settings.json, żeby żaden agent nie mógł edytować klucza odpowiedzi, weryfikatora ani działającego wykonawcy:
{
  "permissions": {
    "deny": [
      "Edit(/evals/answer-key.md)",
      "Edit(/.claude/agents/clone-verifier.md)",
      "Edit(/.claude/agents/clone.md)"
    ]
  }
}
W ustawieniach projektu ukośnik na początku oznacza folder, w którym wystartowała sesja, dlatego Claude Code uruchamiasz z katalogu głównego projektu. Reguły Edit obejmują wszystkie narzędzia Claude’a do edycji plików, łącznie z Write, i obowiązują zarówno główną sesję, jak i każdego subagenta. Tak ma być: nowe przypadki w kluczu i podmiana wykonawcy to twoja robota, w edytorze albo w terminalu.
Trzeba znać granicę. Reguły blokujące dotyczą narzędzi Claude’a, a nie skryptu, który sam otwiera pliki. Dlatego trener nie dostaje Basha. Traktuj te reguły jako zabezpieczenie przed pomyłką, a nie jako piaskownicę. To samo pisałem o bazie wiedzy we wcześniejszym wpisie: reguła, na której ci zależy, powinna siedzieć w hooku albo w uprawnieniach, a nie w prompcie.
Krok 6: napisz komendę rundy#
Wszystkich trzech agentów spina jedna komenda. Zapisz ją jako .claude/commands/improve-clone.md:
---
description: Uruchamia jedną rundę poprawek agenta clone i proponuje kandydata
---

Przeprowadź jedną rundę poprawek agenta clone. Nigdy nie edytuj
.claude/agents/ ani evals/ i nigdy nie podmieniaj działającej wersji.

1. Utwórz folder runs/<RRRR-MM-DD-GGMM>/. Nazywaj go RUN.
2. Przeczytaj evals/answer-key.md i zbierz identyfikator i Pytanie
   każdego przypadku. Pomiń Oczekiwane, Musi zawierać i Nie może.
3. Przebieg wersji działającej: uruchom subagenta general-purpose. Każ
   mu przeczytać .claude/agents/clone.md i traktować wszystko poniżej
   frontmattera jako swoje instrukcje. Przekaż mu tylko identyfikatory
   i pytania. Zapisz odpowiedzi w RUN/live.md, po jednej sekcji
   „## <identyfikator>” na przypadek.
4. Poproś subagenta clone-verifier o ocenę RUN/live.md. Zapisz raport
   w RUN/live-report.md.
5. Jeśli wszystkie przypadki przechodzą, zakończ i podaj wynik.
6. Poproś subagenta clone-coach o jednego kandydata na podstawie
   RUN/live-report.md.
7. Przebieg kandydata: powtórz kroki 3 i 4, używając nowego pliku
   kandydata zamiast .claude/agents/clone.md. Zapisz do RUN/candidate.md
   i RUN/candidate-report.md.
8. Dopisz jedną linijkę do candidates/log.md:
   data | plik kandydata | wynik wersji działającej | wynik kandydata | zmiana | decyzja: czeka
9. Podaj oba wyniki, przypadki naprawione przez kandydata, przypadki,
   które zepsuł, i zmianę w jednym zdaniu. Zarekomenduj przyjęcie albo
   odrzucenie. Kandydat, który psuje przypadek przechodzący w wersji
   działającej, idzie do odrzucenia, nawet jeśli ma wyższy wynik ogólny.
Uruchamianie wersji działającej i kandydata w ten sam sposób, przez subagenta general-purpose wykonującego instrukcje z pliku, zapewnia uczciwe porównanie. Obie wersje dostają te same pytania i działają w tych samych warunkach, różnią się tylko instrukcjami.
Krok 7: uruchom rundę i podmień wersję#
Wpisz /improve-clone. Runda kończy się mniej więcej takim podsumowaniem:
Wersja działająca 15/20, kandydat 17/20.
Naprawione: case-004, case-011. Zepsute: brak.
Zmiana: dodano regułę „Gdy pytanie dotyczy ceny, podaj link do aktualnego
cennika zamiast kwoty”.
Rekomendacja: przyjąć.
Przeczytaj candidates/clone-<n>.why.md i przejrzyj oba pliki z odpowiedziami. Jeśli się zgadzasz, podmień wersję sam:
cp candidates/clone-3.md .claude/agents/clone.md
git add -A && git commit -m "clone: promote candidate 3 (15/20 -> 17/20)"
Potem zmień w logu decyzja: czeka na przyjęty albo odrzucony, żeby trener wiedział o tym następnym razem. Skoro każda podmiana jest w gicie, cofnięcie nieudanej poprawki to git revert, a historia commitów jest przy okazji zapisem tego, co i dlaczego się zmieniło.
Ile swobody dać pętli#
Ta konstrukcja obsługuje trzy poziomy. Wybierz jeden świadomie.
Poziom 1: ty zauważasz, Claude poprawia instrukcje. Nie potrzebujesz żadnego z opisanych wyżej elementów. Gdy jakiś skill albo agent pomyli się w zwykłej sesji, napisz:
Na podstawie tej rozmowy zaktualizuj skill albo agenta, którego użyłem,
żeby to się nie powtórzyło. Zanim zapiszesz, pokaż mi zmiany.
Działa od pierwszego dnia i wystarcza dla większości codziennych skilli. Przy działającej pętli odpowiednikiem tego nawyku jest dopisanie błędnie obsłużonego pytania do klucza.
Poziom 2: pętla proponuje, ty zatwierdzasz. To układ opisany w krokach od 1 do 7 i na nim powinna zostać większość pracy, której wyniku nie sprawdzi automatyczny test. Agent poprawia się na podstawie dowodów, a ostatnie słowo należy do ciebie. Tak samo działa audyt w mojej bazie wiedzy: znajduje problemy i proponuje poprawki, ale nic nie wchodzi bez mojej zgody.
Poziom 3: pętla sama podmienia wersje. Usuń regułę Edit(/.claude/agents/clone.md) i dodaj drugą komendę, .claude/commands/auto-improve-clone.md:
---
description: Uruchamia kolejne rundy poprawek agenta clone i sama wprowadza zwycięzców
---

Przeprowadź rundę opisaną w .claude/commands/improve-clone.md maksymalnie
10 razy. Po każdej rundzie przyjmij kandydata tylko wtedy, gdy ma wyższy
wynik i nie psuje żadnego przypadku, który przechodził w wersji
działającej: skopiuj go na .claude/agents/clone.md, oznacz jego linijkę
w logu jako przyjęty i zrób commit z oboma wynikami w opisie. W przeciwnym
razie oznacz go jako odrzucony.

Zakończ, gdy wszystkie przypadki przechodzą, gdy trzy rundy z rzędu kończą
się odrzuceniem albo po 10 rundach. Wypisz każdą podmianę razem z wynikami.
Zawsze ustaw limit. Bez niego pętla będzie wydawać tokeny na przypadek, którego nie potrafi naprawić. Poziom 3 ma sens tam, gdzie ocena to twarde „przechodzi albo nie”, czyli w praktyce przy kodzie z testami. Jeśli twój klucz wymaga oceny tonu albo kompletności, pętla działająca bez nadzoru będzie powoli zmieniać agenta w sposób, którego przestaniesz rozumieć, a jego zachowanie stanie się trudniejsze do przewidzenia. Tam zostań na poziomie 2.
Od czego to naprawdę zależy#
- Od klucza odpowiedzi, a nie od agentów. Dwadzieścia prawdziwych przypadków z zatwierdzonymi odpowiedziami jest wartych więcej niż najsprytniejszy trener. Bez nich weryfikator nie ma do czego porównywać, a pętla poprawia agenta na ślepo.
- Od jednej zmiany na kandydata. Tylko tak wiadomo, co pomogło.
- Od uprawnień w konfiguracji. Lista narzędzi weryfikatora i reguły blokujące robią dla wiarygodności wyników więcej niż jakiekolwiek zdanie w prompcie.
- Od tego, że wykonawca nie widzi oczekiwanych odpowiedzi. Komenda przekazuje mu tylko pytania. Jeśli wykonawca może przeczytać klucz, każdy wynik jest zawyżony.
- Od zamieniania każdej porażki w przypadek. Klucz powinien rosnąć razem z użyciem. Błędna odpowiedź w codziennej pracy to nie wpadka, tylko kolejny test.
Samodoskonalenie nie oznacza tu agenta, który przepisuje się, aż zmądrzeje. Oznacza pętlę informacji zwrotnej, którą sam zaprojektowałeś, z wyraźną granicą między decyzjami agentów a decyzjami, które zostają przy tobie.